用 SQL 操作 Milvus:从检索到 ORM
Java 应用通常通过 Milvus SDK 写入数据和检索向量。对关系型数据库开发者来说,SQL 和 JDBC 更熟悉。jdbc-milvus 让这套使用方式也能用于 Milvus:
SELECT id, title, score FROM intro_articles -- score 为 L2 平方距离,越小越接近
WHERE category = 'java'                    -- 只在 Java 类别内检索
ORDER BY embedding <-> [1,0] LIMIT 2;       -- 按向量距离取最近的两条
加入 dbVisitor,还可以用实体映射和查询构造器完成同样的检索:
@Table("intro_articles")
public class Article {
    @Column(primary = true)
    private Long id;
    private String title;
    private String category;
    private List<Float> embedding;
    // 省略标准 getter、setter
}
LambdaTemplate lambda = new LambdaTemplate(conn);
List<Article> articles = lambda.query(Article.class)
        .eq(Article::getCategory, "java")
        .orderByL2(Article::getEmbedding, List.of(1F, 0F))
        .initPage(2, 0)
        .queryForList();
用 SQL 理解 Milvus
jdbc-milvus 由 dbVisitor 项目开发,将支持的 SQL 转换为 Milvus API 调用。SQL 与 Milvus 的对应关系如下:
| 场景 | 解决办法 | Milvus 中的含义 |
|---|---|---|
| 定义数据结构 | CREATE TABLE 定义表与列 | 表对应 Collection,行对应 Entity,列对应 Field |
| 准备向量索引 | CREATE INDEX 指定向量字段与距离度量 | 建立用于相似度检索的索引 |
| 写入与导入数据 | INSERT、IMPORT | 写入实体或批量导入文件 |
| 加载集合 | LOAD TABLE | 让集合可供查询与检索 |
| 按条件检索相似记录 | WHERE + ORDER BY embedding <-> ... LIMIT K | 在符合条件的实体中,按 L2 距离查找最近的 K 个向量 |
| 组合多路检索 | ORDER BY HYBRID | 组合稠密向量、BM25 等检索路径,以 RRF 或 Weighted 重排 |
数据准备
示例使用 Milvus 2.6.2+,以下 SQL 可通过 JDBC、DataGrip 或 DBeaver 逐条执行:
-- 定义集合;FLOAT_VECTOR(2) 为二维向量字段。
CREATE TABLE intro_articles (
    id INT64 PRIMARY KEY, title VARCHAR(256),
    category VARCHAR(32), embedding FLOAT_VECTOR(2)
) WITH (consistency_level='Strong');

-- 建立向量索引:AUTOINDEX 自动选择索引,L2 度量对应查询中的 <->。
CREATE INDEX idx_embedding ON intro_articles(embedding)
USING AUTOINDEX WITH (metric_type='L2');

-- 写入文章及其向量。
INSERT INTO intro_articles(id,title,category,embedding) VALUES
(1,'Vector introduction','java',[1,0]),
(2,'Mapper guide','java',[0,1]),
(3,'Other category','python',[1,0]);

-- 加载集合后即可检索。
LOAD TABLE intro_articles;
JDBC 接入
Java 17+ 应用的 Maven 依赖:
<!-- Milvus JDBC 驱动:通过 SQL 访问 Milvus -->
<dependency>
    <groupId>net.hasor</groupId>
    <artifactId>jdbc-milvus</artifactId>
    <version>6.8.1</version>
</dependency>
<!-- 使用对象映射、查询构造器与 Mapper 时加入 -->
<dependency>
    <groupId>net.hasor</groupId>
    <artifactId>dbvisitor</artifactId>
    <version>6.8.0</version>
</dependency>
String url = "jdbc:dbvisitor:milvus://127.0.0.1:19530/default";
Properties props = new Properties();
props.setProperty("consistencyLevel", "Strong");
- 已配置:设置为
Strong,写入成功后马上能查到新数据,但查询可能慢一点。 - 未配置:沿用集合设置。默认
Bounded下,新数据可能要过一会儿才能查到。
执行查询
try (Connection conn = DriverManager.getConnection(url, props);
     PreparedStatement search = conn.prepareStatement(
             "SELECT id,title,score FROM intro_articles WHERE category = ? ORDER BY embedding <-> ? LIMIT 2")) {
    search.setString(1, "java");
    search.setObject(2, new float[] {1, 0});
    try (ResultSet rows = search.executeQuery()) {
        while (rows.next()) {
            System.out.println(rows.getLong("id") + " | " + rows.getString("title") + " | " + rows.getFloat("score"));
        }
    }
}
查询结果:
| id | title | score |
|---|---|---|
| 1 | Vector introduction | 0.0 |
| 2 | Mapper guide | 2.0 |
ORM 映射
dbVisitor 支持与 Spring、Hasor、Solon、Guice 四个开发框架集成。
用 Mapper 方法注解将 SQL 封装为业务方法。结果对象 ArticleHit 包含 id、title、score 属性及 getter/setter:
@SimpleMapper
public interface ArticleMapper {
    @Query("""
        SELECT id,title,score FROM intro_articles
        WHERE category = #{category}
        ORDER BY embedding <-> #{vector} LIMIT 2
        """)
    List<ArticleHit> nearest(@Param("category") String category,
                             @Param("vector") List<Float> vector);
}
try (Session session = new Configuration().newSession(DriverManager.getConnection(url, props))) {
    ArticleMapper mapper = session.createMapper(ArticleMapper.class);
    for (ArticleHit hit : mapper.nearest("java", List.of(1F, 0F))) {
        System.out.println(hit.getTitle());
    }
}
查询构造器可以组合条件与向量排序,例如查询同类别的相似文章并排除自身:
try (Connection conn = DriverManager.getConnection(url, props)) {
    LambdaTemplate lambda = new LambdaTemplate(conn);
    Article current = lambda.query(Article.class).eq(Article::getId, 1L).queryForObject();
    List<Article> related = lambda.query(Article.class)
            .eq(Article::getCategory, current.getCategory())
            .ne(Article::getId, current.getId())
            .orderByL2(Article::getEmbedding, current.getEmbedding())
            .initPage(5, 0)
            .queryForList();
}
也可以采用 MyBatis 风格的 XML。将接口注解换成 @RefMapper,移除方法上的 @Query:
package example;

@RefMapper("/mapper/articles.xml")
public interface ArticleMapper {
    List<ArticleHit> nearest(@Param("category") String category,
                             @Param("vector") List<Float> vector);
}
MyBatis 风格的 XML 配置如下:
<mapper namespace="example.ArticleMapper">
<select id="nearest" resultType="example.ArticleHit">
SELECT id, title, score FROM intro_articles
<where>
<if test="category != null">
category = #{category}
</if>
</where>
ORDER BY embedding <-> #{vector} LIMIT 2
</select>
</mapper>
传 null 时,XML 中的 <if> 不生成类别条件:
ArticleMapper mapper = session.createMapper(ArticleMapper.class);
List<ArticleHit> javaHits = mapper.nearest("java", List.of(1F, 0F));
List<ArticleHit> allHits = mapper.nearest(null, List.of(1F, 0F));
SQL 支持范围
- 集合、索引与分区管理:
CREATE / ALTER / DROP TABLE、CREATE / DROP INDEX、CREATE / DROP PARTITION。 - 数据写入与修改:
INSERT、UPSERT、UPDATE、DELETE。 - 文件批量导入:
IMPORT,通过SHOW IMPORT查询任务状态。 - 普通查询与计数:
SELECT ... WHERE ... LIMIT ...、SELECT COUNT(*)。 - 向量与混合检索:
ORDER BY距离算子、ORDER BY HYBRID;支持 L2、COSINE、IP 等度量。 - 集合加载与状态查看:
LOAD/RELEASE TABLE、SHOW TABLES、SHOW INDEXES、SHOW STATS。
SQL Client
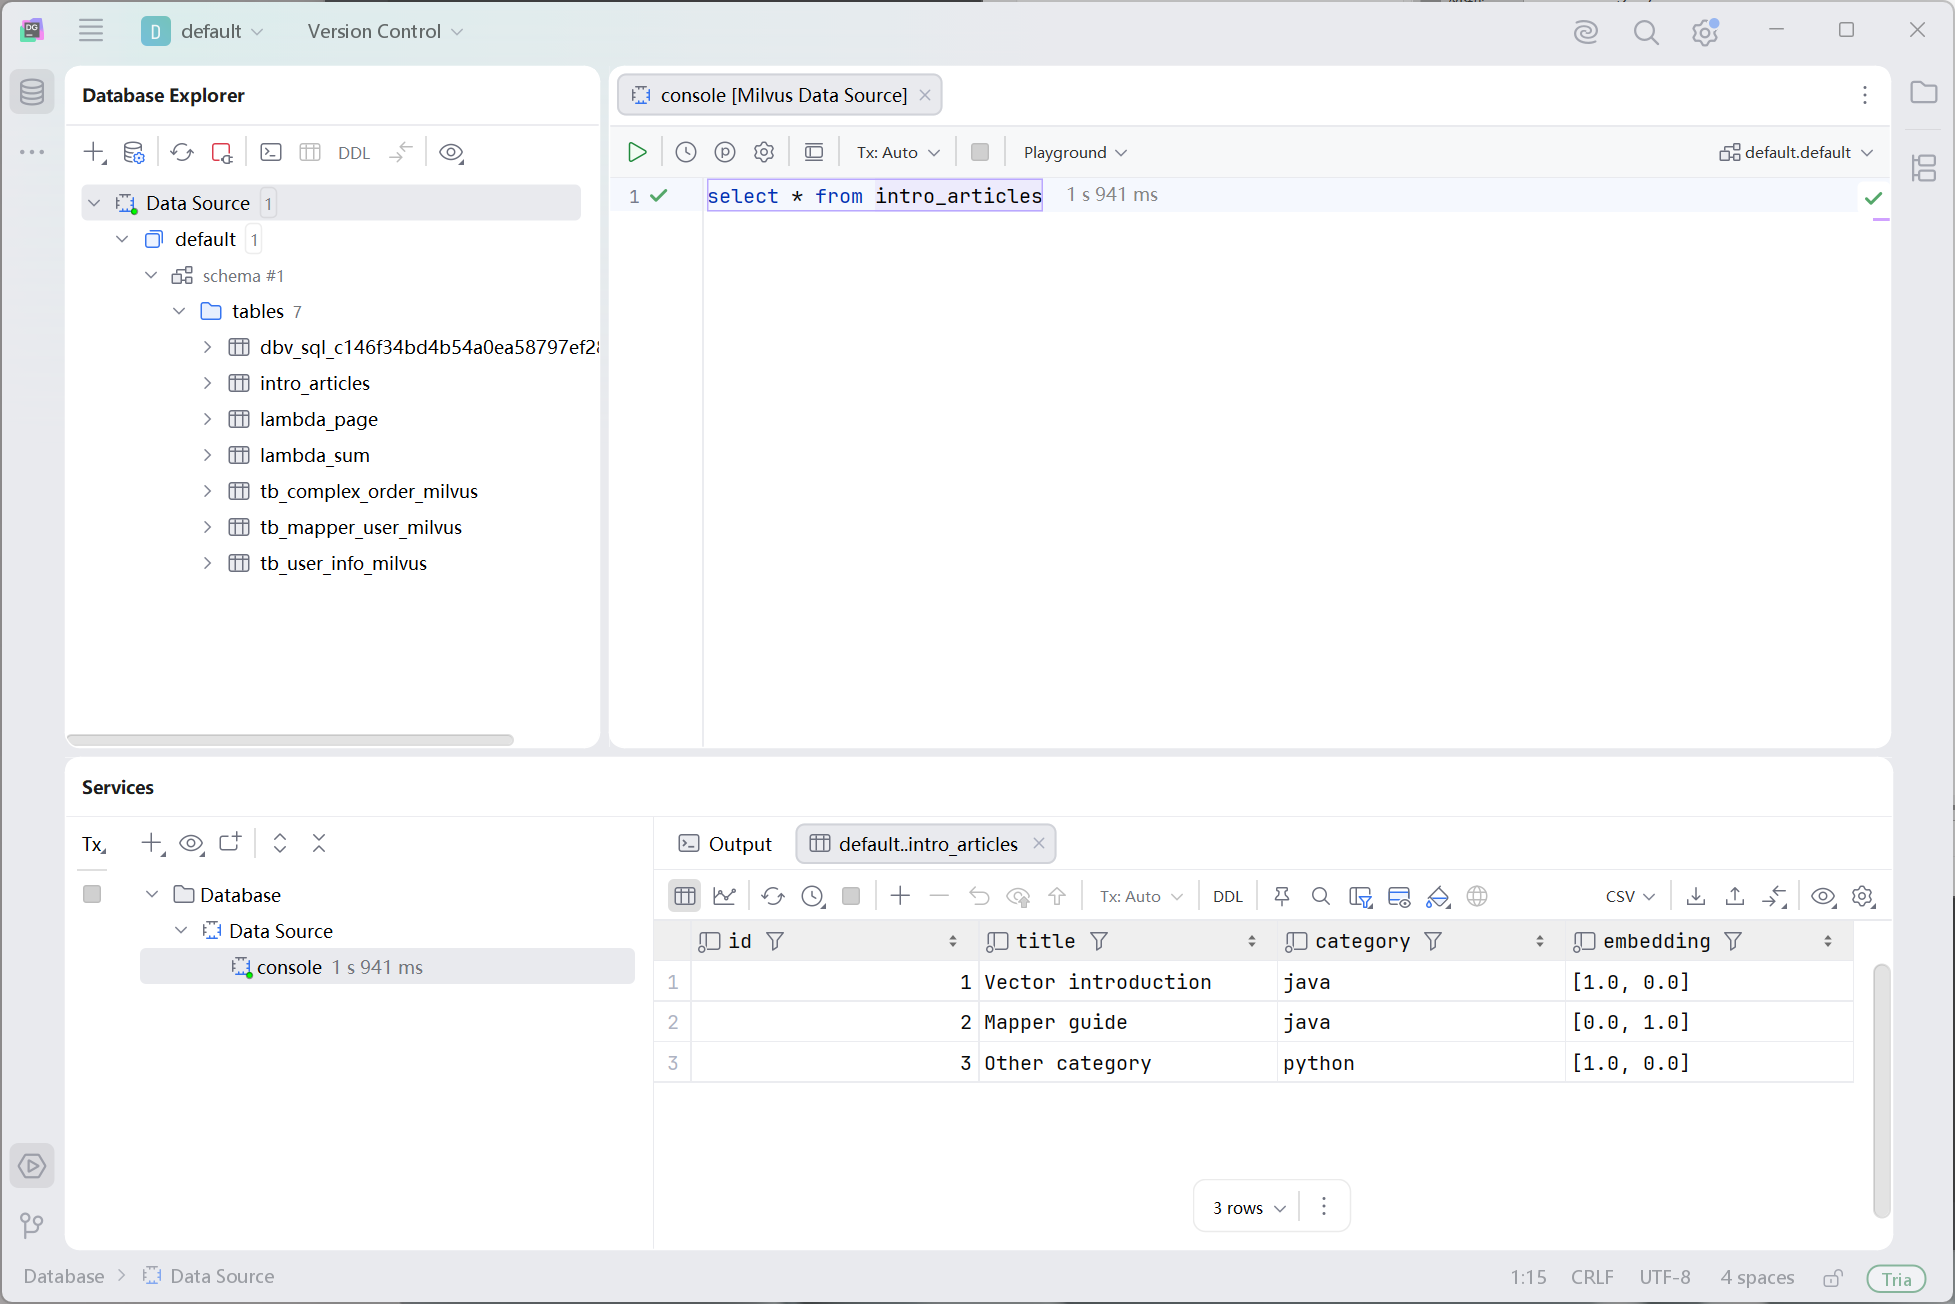
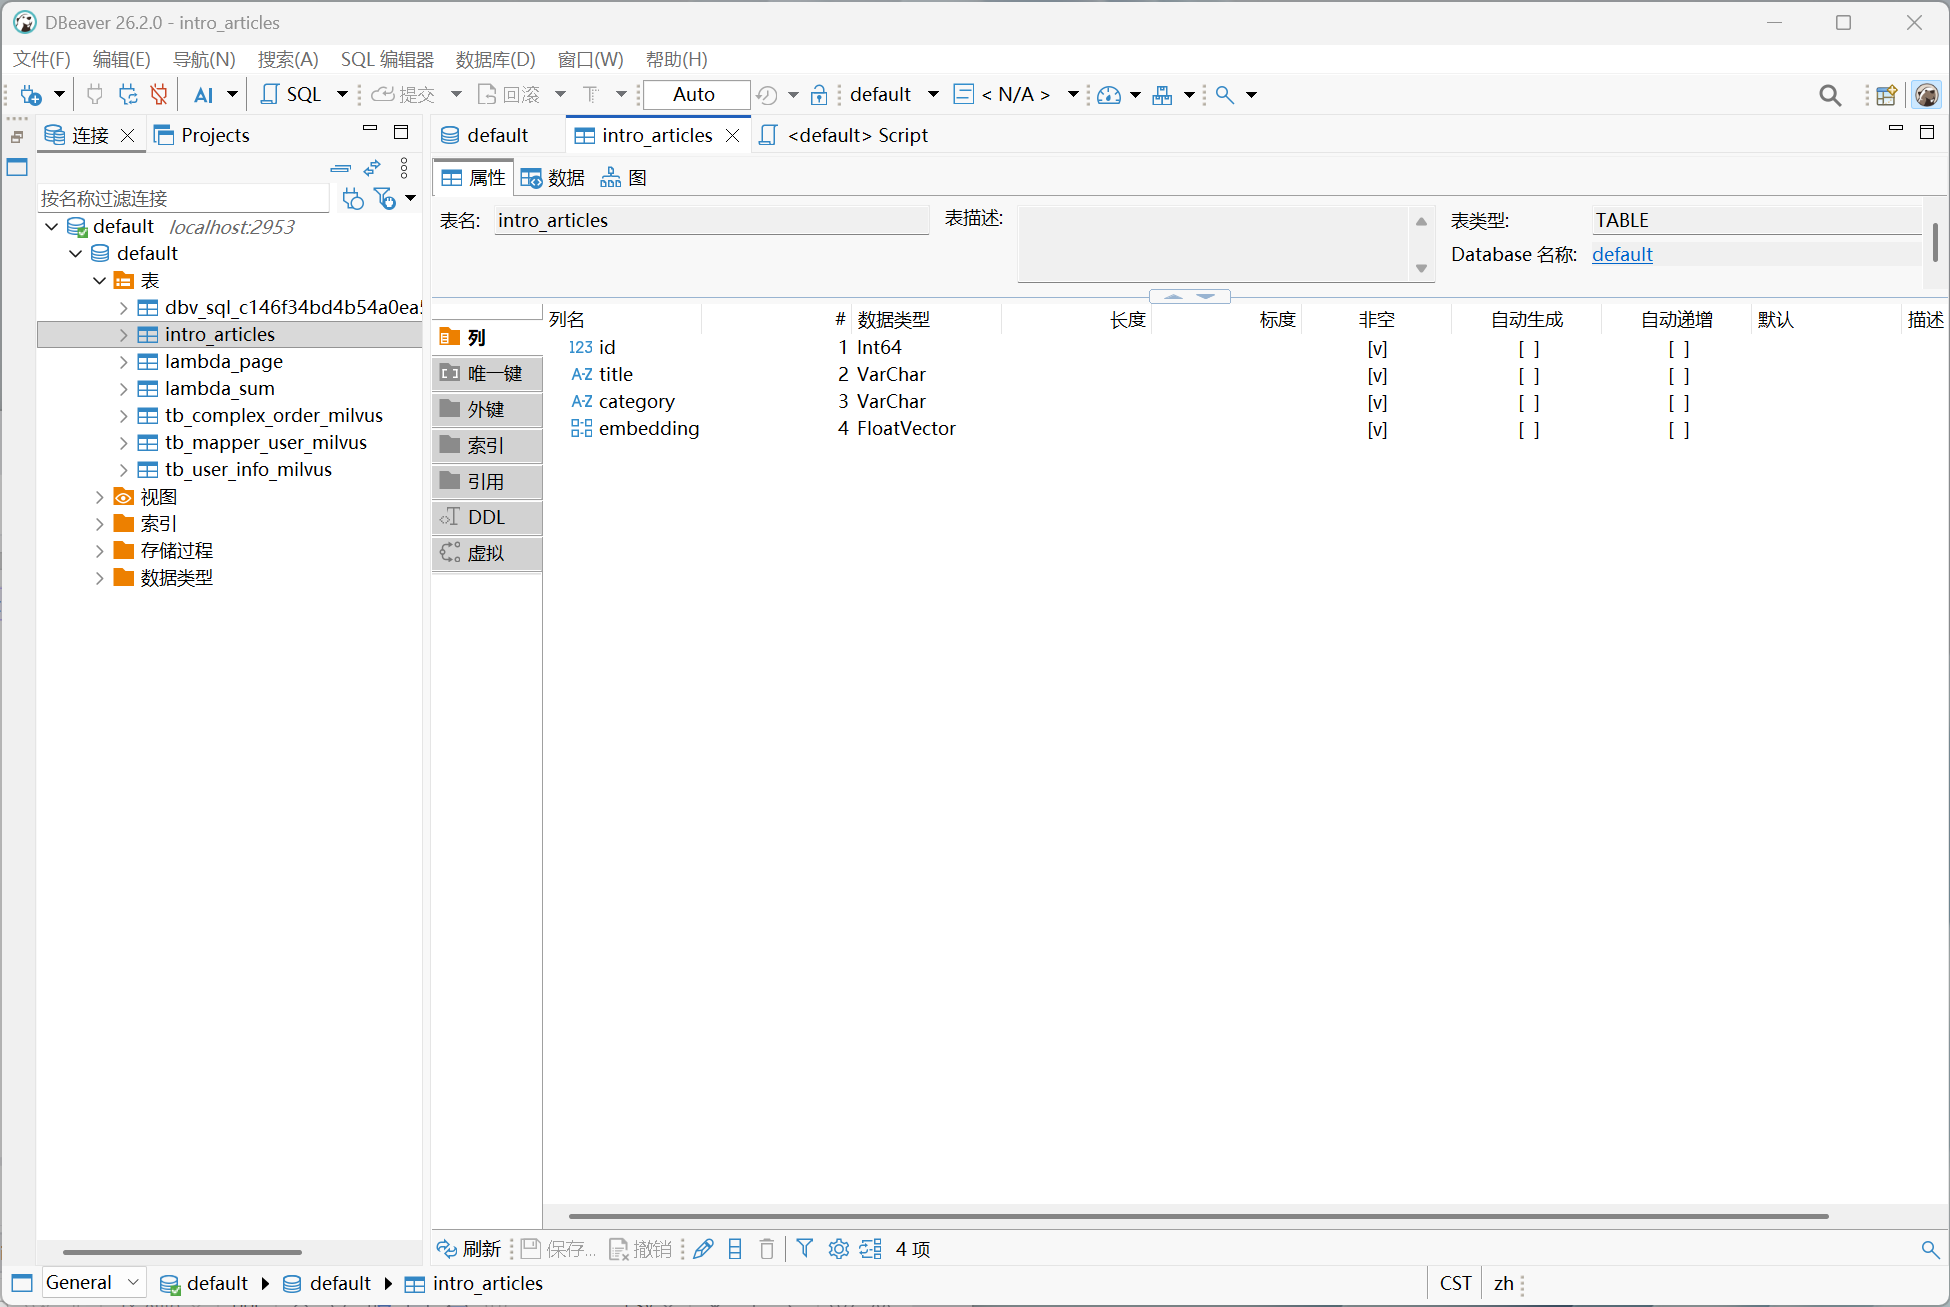
SQL 不只用于应用代码。通过 JDBC 驱动,也可以在 DataGrip、DBeaver 等 SQL Client 中准备数据、调试向量检索,并以表格查看查询结果。
- DataGrip
- DBeaver
到 Milvus SQL Client 页面下载 alone 驱动包,运行驱动的 Java 环境需为 17 或以上。
| 项目 | 配置 |
|---|---|
| 驱动名称 | dbVisitor Milvus |
| 驱动文件 | 下载的 jdbc-milvus-6.8.1-alone.jar |
| 驱动类 | net.hasor.dbvisitor.driver.JdbcDriver |
| 主机 | 127.0.0.1,替换为自己的 Milvus 地址 |
| 端口 | 19530 |
| 数据库 | default,或实际已创建的数据库 |
DataGrip
- 打开 File → Data Sources → Drivers → +,填写驱动名称,在 Driver Files → + → Custom JARs 中添加 JAR,Class 填入上表的驱动类。
- 在 General → URL templates 中添加以下模板,点击 Apply → Create Data Source。
- 选择模板对应的连接类型,填写主机、端口和数据库。启用认证时填写用户名和密码,点击 Test Connection,通过后保存。查询控制台的事务模式选择 Auto,Switch schema 设为 Disable。
jdbc:dbvisitor:milvus://{host}:{port}/{database}\?consistencyLevel=Strong
DBeaver
- 打开 Database → Driver Manager → New,填写驱动名称,类型选择 Generic。
- 在 Libraries → Add File 中添加 JAR,Class Name 填入上表的驱动类,Default Port 填
19530,URL Template 使用以下模板。 - 保存驱动,用它新建连接,填写主机、端口、数据库及认证信息。点击 Test Connection,通过后打开 SQL 编辑器,保持 Auto-commit。
jdbc:dbvisitor:milvus://{host}:{port}/{database}?consistencyLevel=Strong
jdbc:dbvisitor:milvus://127.0.0.1:19530/default?consistencyLevel=Strong
其他驱动参数在 DataGrip 的 Advanced 或 DBeaver 的 Driver properties 中填写,参数名称和值见连接参数。操作界面可参照 DataGrip 自定义驱动和 DBeaver 驱动管理器。
准备好前文的数据后,在控制台执行:
SELECT id, title, score FROM intro_articles
WHERE category = 'java'
ORDER BY embedding <-> [1, 0] LIMIT 2;
结果表中会看到 Vector introduction、Mapper guide 两条记录,距离分别为 0、2。调整类别或查询向量,就能直接对比检索结果,再将验证后的 SQL 用于 JDBC 代码或 Mapper。